Descubre cómo los datos de entrenamiento impulsan el aprendizaje de los modelos de Inteligencia Artificial, su papel esencial en el desarrollo de sistemas inteligentes y cómo su calidad impacta en resultados reales.

Datos de entrenamiento: fundamento esencial en la Inteligencia Artificial
Los datos de entrenamiento son el conjunto de información estructurada o no estructurada que se utiliza para enseñar a los modelos de Inteligencia Artificial (IA) a reconocer patrones, realizar predicciones y automatizar tareas. En el contexto de aprendizaje automático (machine learning) y modelos de lenguaje (como los LLMs), estos datos permiten que los algoritmos ajusten sus parámetros internos para mejorar su precisión y relevancia en aplicaciones prácticas.
El uso de datos de entrenamiento surge como respuesta a la necesidad de que las máquinas aprendan de ejemplos reales, en lugar de seguir reglas programadas de forma rígida. Gracias a esta técnica, la IA es capaz de adaptarse a nuevas situaciones, identificar tendencias y resolver problemas complejos en diferentes áreas, desde la medicina hasta la automatización empresarial.
Las Herramientas de IA que los Profesionales
ya están Usando para Dominar el 2030
Cada semana que pasa, más profesionales ya están usando estas herramientas para avanzar con ventaja real. Aquí tienes las dos que marcan la diferencia — probadas y recomendadas por Xiluvo.com.
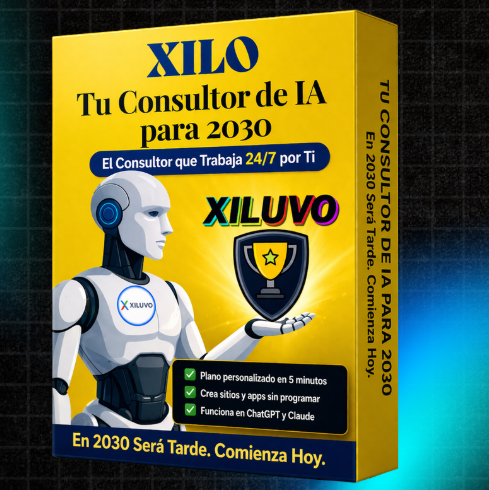
XILO — Tu Consultor Personal de IA para 2030
El asistente de IA más completo en cualquier idioma. 12 modos especializados, disponible 24/7, listo para usar hoy en ChatGPT o Claude.
⚠️ Cada semana se vuelve más difícil arrancar sin una guía clara.
- 12 modos especializados — diagnóstico, prompts, SEO, apps y más
- Multilingüe — detecta tu idioma automáticamente
- Compatible con ChatGPT Plus y Claude Pro
- Pago único · Acceso vitalicio · Sin mensualidades
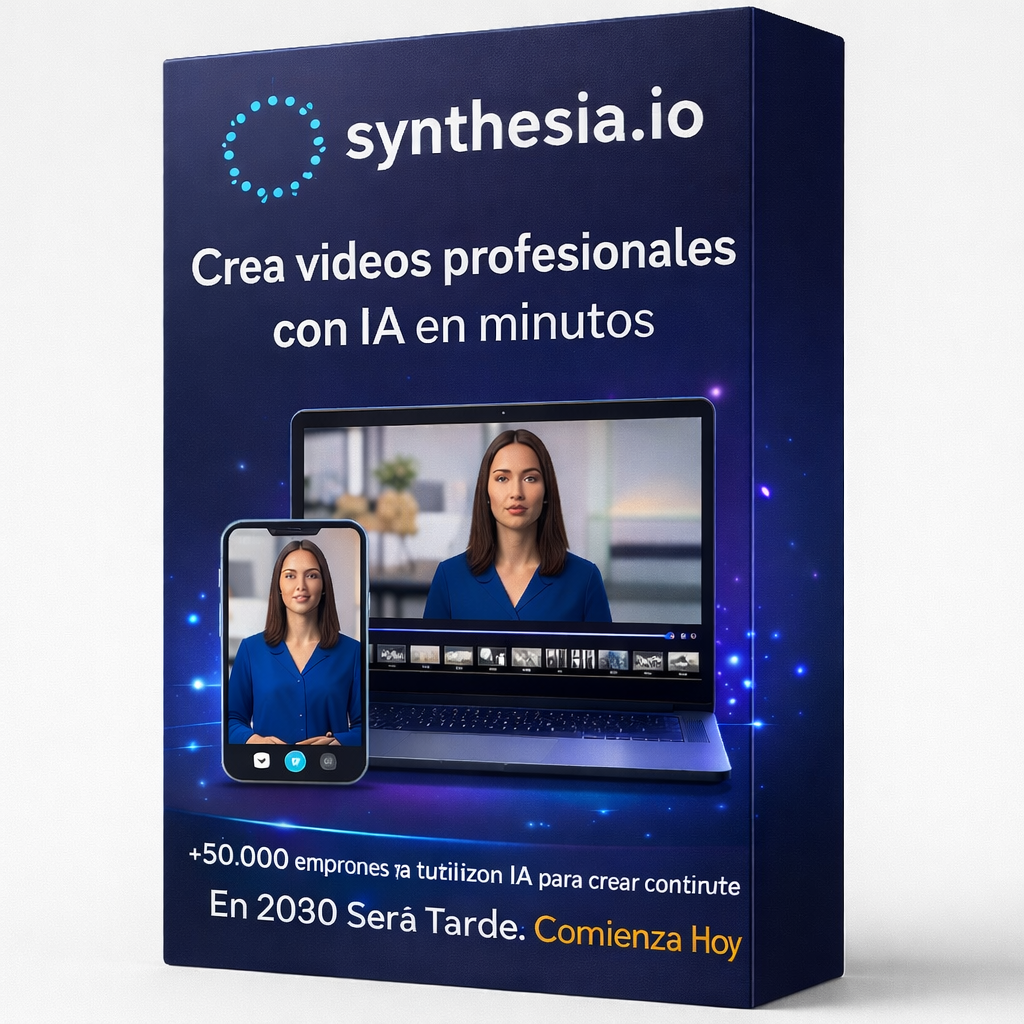
Synthesia — Crea Videos Profesionales con IA en Minutos
La plataforma líder de vídeo con IA. Avatares realistas, voces en más de 120 idiomas y producción profesional sin cámara ni estudio.
⚠️ Las marcas más rápidas ya producen contenido con IA a gran escala.
- +230 avatares de IA con aspecto 100% real
- 120+ idiomas con sincronización labial perfecta
- Sin cámara, sin micrófono, sin estudio
- Ideal para cursos, marketing y formación empresarial
Para quienes buscan comprender el funcionamiento de la IA, los datos de entrenamiento representan el punto de partida para el desarrollo de sistemas inteligentes, ya que definen el alcance, la calidad y las limitaciones de los modelos generados.
Esta base de datos es fundamental para abordar desafíos como la clasificación de imágenes, la generación de texto, el reconocimiento de voz, la predicción financiera y la personalización de servicios digitales.
Sin embargo, la calidad, cantidad y diversidad de los datos de entrenamiento determinan el éxito o fracaso de los modelos de IA, lo que implica retos importantes en términos de recolección, limpieza, privacidad y ética.
¿Cómo funcionan los datos de entrenamiento en los modelos de IA?
El funcionamiento de los datos de entrenamiento en los modelos de Inteligencia Artificial se basa en el proceso de aprendizaje supervisado, no supervisado o por refuerzo, según el enfoque adoptado. En el aprendizaje supervisado, los datos de entrenamiento incluyen tanto las entradas (por ejemplo, imágenes, textos, registros) como las salidas esperadas (etiquetas o respuestas correctas), permitiendo que el modelo aprenda la relación entre ambos.
Durante la fase de entrenamiento, el algoritmo procesa grandes volúmenes de datos, ajustando sus parámetros internos mediante técnicas matemáticas y estadísticas para minimizar errores y mejorar la precisión. Este proceso se repite iterativamente hasta que el modelo alcanza un nivel de desempeño satisfactorio.
En el aprendizaje no supervisado, los datos de entrenamiento no están etiquetados; el modelo busca patrones, agrupaciones o estructuras ocultas sin información previa sobre la salida correcta. Por su parte, el aprendizaje por refuerzo utiliza datos de experiencia e interacción con el entorno para optimizar decisiones a través de recompensas y penalizaciones.
La selección, preparación y validación de los datos de entrenamiento son pasos críticos para evitar sesgos, errores y resultados no deseados en la implementación de sistemas de IA.
- Permiten que los modelos de IA aprendan y generalicen a partir de ejemplos reales.
- Definen el alcance y la precisión de las predicciones en aplicaciones prácticas.
- Son esenciales para ajustar y validar el funcionamiento de modelos en producción.
- Influyen directamente en la capacidad de la IA para adaptarse a nuevos escenarios y tareas.

Aplicaciones prácticas de los datos de entrenamiento en Inteligencia Artificial
El uso de datos de entrenamiento se extiende a una amplia gama de aplicaciones dentro de la Inteligencia Artificial, desde la IA generativa y los modelos de lenguaje hasta la automatización inteligente en la industria y los servicios digitales. En cada caso, los datos de entrenamiento permiten que los sistemas realicen tareas que antes solo podían ejecutar los humanos.
Un ejemplo relevante es el entrenamiento de modelos de lenguaje natural (NLP) como GPT, BERT o similares, que utilizan grandes corpus de texto para aprender a comprender, generar y traducir lenguaje humano. Asimismo, en visión por computadora, los datos de entrenamiento consisten en millones de imágenes etiquetadas para que el modelo aprenda a identificar objetos, rostros o anomalías.
Las herramientas de IA que los profesionales ya están usando
para dominar el 2030
Descubre una selección estratégica de herramientas y agentes de inteligencia artificial para emprendedores, creadores y negocios que quieren avanzar hoy con una ventaja real.
XILO — Tu Consultor Personal de IA para 2030
Un consultor de IA diseñado para ayudarte a pensar, planificar, crear y ejecutar con más claridad. Ideal para quienes quieren resultados prácticos sin perder tiempo.
⚠️ Cada semana se vuelve más competitivo dominar la IA con ventaja real.
- Plan personalizado para avanzar con IA desde hoy
- Te ayuda con ideas, estrategia, productividad y ejecución
- Perfecto para emprendedores, creadores y negocios digitales
- Acceso rápido y enfoque práctico orientado al futuro
Synthesia — Crea Videos Profesionales con IA en Minutos
Crea videos profesionales sin cámaras, sin estudio y sin procesos complejos. Una solución ideal para formación, marketing, ventas y contenido empresarial.
⚠️ Las marcas más rápidas ya están produciendo contenido con IA a gran escala.
- Crea videos con IA en minutos y con aspecto profesional
- Ideal para empresas, presentaciones, ventas y formación
- Ahorra tiempo, costes y esfuerzo de producción
- Perfecto para escalar contenido sin complicaciones
En el sector financiero, los datos históricos de transacciones y comportamientos de mercado entrenan modelos para detectar fraudes, predecir tendencias y automatizar inversiones. En salud, los datos de imágenes médicas, historiales y diagnósticos permiten desarrollar sistemas de apoyo a la decisión clínica.
La personalización de recomendaciones en plataformas digitales, la optimización de procesos logísticos y la mejora de la experiencia del usuario en SaaS con IA también dependen de la calidad y representatividad de los datos de entrenamiento.
- Reconocimiento de voz y asistentes virtuales.
- Diagnóstico médico asistido por IA.
- Automatización de procesos empresariales.
- Generación de contenido y traducción automática.
- Detección de fraudes y ciberseguridad.

Ventajas, limitaciones y puntos de atención en el uso de datos de entrenamiento
La principal ventaja de los datos de entrenamiento radica en la capacidad de la IA para aprender, adaptarse y mejorar continuamente a partir de ejemplos reales. Esto permite automatizar tareas, aumentar la productividad y ofrecer soluciones innovadoras en múltiples sectores.
No obstante, existen limitaciones importantes que deben considerarse. La calidad de los datos es fundamental: datos incompletos, sesgados o desactualizados pueden llevar a modelos ineficientes o decisiones erróneas. Además, la privacidad y la protección de datos personales representan retos éticos y legales que requieren atención constante.
El uso de datos de entrenamiento también puede generar riesgos de dependencia excesiva de la IA, pérdida de contexto humano y posibles alucinaciones o errores si el modelo se enfrenta a situaciones no representadas en los datos originales.
Por ello, es esencial complementar el entrenamiento de la IA con validación humana, monitoreo continuo y aplicación de principios de gobernanza responsable.
- Mejora la precisión y capacidad de adaptación de los modelos de IA.
- Permite la automatización de tareas complejas y repetitivas.
- Impulsa la innovación en sectores clave como salud, finanzas y educación.
- Requiere control de calidad, gestión de sesgos y protección de datos.

Tabla comparativa: datos de entrenamiento y su impacto en la IA
| Concepto, Modelo o Tema de IA | ¿Qué significa en la práctica? | Punto de Atención / Contexto Necesario | ¿Para quién es indicado? |
|---|---|---|---|
| Datos de entrenamiento | Base de ejemplos reales para que los modelos de IA aprendan y realicen tareas específicas | La calidad y diversidad son críticas; datos sesgados generan resultados poco fiables | Desarrolladores, investigadores, empresas, equipos de innovación, estudiantes |
| Modelos de lenguaje (LLMs) | Procesan y generan texto a partir de grandes corpus de datos de entrenamiento | Posibles sesgos lingüísticos y culturales; necesidad de revisión humana | Creadores de contenido, profesionales de IA, equipos de producto digital |
| Automatización inteligente | Optimiza procesos y tareas repetitivas mediante modelos entrenados con datos históricos | Requiere monitoreo continuo y ajustes para evitar errores automáticos | Empresas, industrias, responsables de operaciones y transformación digital |
| Aprendizaje supervisado | Entrena modelos de IA con datos etiquetados para tareas de clasificación o predicción | Dependencia de datos correctamente etiquetados; riesgo de sobreajuste | Investigadores, científicos de datos, educadores y estudiantes de IA |
Relevancia de los datos de entrenamiento para el presente y el futuro de la IA
En la actualidad, el uso estratégico de datos de entrenamiento es fundamental para el desarrollo de soluciones de IA robustas, escalables y éticamente responsables. A medida que la Inteligencia Artificial evoluciona, la demanda de datos diversos, representativos y de alta calidad crece de forma exponencial, especialmente en IA generativa, automatización con IA y aplicaciones en SaaS.
La correcta gestión de estos datos es clave para afrontar desafíos futuros, como la reducción de sesgos, la transparencia en la toma de decisiones automatizadas y la protección de la privacidad individual. Además, la capacidad de recopilar, limpiar y validar datos de entrenamiento seguirá siendo un factor diferenciador en la competencia tecnológica global hasta 2030 y más allá.
Las Herramientas de IA que los Profesionales
ya están Usando para Dominar el 2030
Cada semana que pasa, más profesionales ya están usando estas herramientas para avanzar con ventaja real. Aquí tienes las dos que marcan la diferencia — probadas y recomendadas por Xiluvo.com.
XILO — Tu Consultor Personal de IA para 2030
El asistente de IA más completo en cualquier idioma. 12 modos especializados, disponible 24/7, listo para usar hoy en ChatGPT o Claude.
⚠️ Cada semana se vuelve más difícil arrancar sin una guía clara.
- 12 modos especializados — diagnóstico, prompts, SEO, apps y más
- Multilingüe — detecta tu idioma automáticamente
- Compatible con ChatGPT Plus y Claude Pro
- Pago único · Acceso vitalicio · Sin mensualidades
Synthesia — Crea Videos Profesionales con IA en Minutos
La plataforma líder de vídeo con IA. Avatares realistas, voces en más de 120 idiomas y producción profesional sin cámara ni estudio.
⚠️ Las marcas más rápidas ya producen contenido con IA a gran escala.
- +230 avatares de IA con aspecto 100% real
- 120+ idiomas con sincronización labial perfecta
- Sin cámara, sin micrófono, sin estudio
- Ideal para cursos, marketing y formación empresarial
Para quienes desean prepararse para el futuro digital, comprender el papel de los datos de entrenamiento en la IA es esencial para el desarrollo de proyectos innovadores, el aprendizaje continuo y la aplicación consciente de la tecnología.
Recomendamos consultar otros recursos del Portal Educacional Xiluvo.com para profundizar sobre modelos de IA, buenas prácticas en ingeniería de datos, ética en IA y tendencias tecnológicas del futuro. También puedes explorar el Glosario de Inteligencia Artificial o ver preguntas frecuentes sobre IA para ampliar tu aprendizaje.
Preguntas frecuentes y recursos para profundizar
¿Quieres saber más sobre cómo se seleccionan, procesan y validan los datos de entrenamiento en proyectos de IA? Te invitamos a ver otros guías sobre Inteligencia Artificial y a explorar herramientas de IA que facilitan la gestión de datos y la mejora de modelos.
Receba mais conteúdos como este!
Cadastre-se para receber atualizações e novos termos em primeira mão.
Para quienes buscan aplicaciones prácticas, recomendamos revisar la guía completa sobre el futuro digital de la IA y las formas en que la IA cambiará el mundo en 2030.
Recuerda que la validación humana, la revisión ética y el pensamiento crítico son pilares para el uso responsable de la Inteligencia Artificial, especialmente en el manejo y aplicación de datos de entrenamiento.
Conclusión: uso consciente y estratégico de los datos de entrenamiento en IA
En nuestra explicación técnica, los datos de entrenamiento constituyen el motor principal detrás del aprendizaje y la capacidad predictiva de los modelos de Inteligencia Artificial. Su correcta gestión permite desarrollar sistemas más precisos, eficientes y adaptativos en una amplia variedad de escenarios de estudio, trabajo y negocio digital.
Entre los principales aprendizajes destacan la importancia de la calidad y diversidad de los datos, la necesidad de controles éticos y técnicos, así como el impacto real en la automatización, personalización y toma de decisiones informadas.
Para aprovechar al máximo el potencial de la IA, es fundamental aplicar buenas prácticas en la recolección, preparación y validación de datos de entrenamiento, siempre considerando los riesgos y limitaciones inherentes a la tecnología.
Te invitamos a explorar el futuro de la Inteligencia Artificial y a mantenerte actualizado con los recursos educativos, guías prácticas y análisis editoriales del Xiluvo.com, fortaleciendo tu conocimiento y preparación para la era digital.
Este contenido fue elaborado con apoyo de Inteligencia Artificial como herramienta auxiliar, siguiendo buenas prácticas editoriais, principios de responsabilidad informacional y uso consciente de la tecnología, con revisión humana para garantizar claridad, precisión técnica, imparcialidad y compromiso con las directrices de Google, así como con estándares de calidad para SEO, GEO y sistemas de respuesta por Inteligencia Artificial.
FAQ Sobre ¿Para qué sirven los datos de entrenamiento en los modelos de Inteligencia Artificial?
¿Qué son los datos de entrenamiento en los modelos de Inteligencia Artificial?
Los datos de entrenamiento son conjuntos de información estructurada o no estructurada que se utilizan para enseñar a un modelo de Inteligencia Artificial a identificar patrones, reconocer relaciones y tomar decisiones. Estos datos pueden ser texto, imágenes, audio, números u otros tipos de información, dependiendo del tipo de modelo y su objetivo.
¿Por qué son importantes los datos de entrenamiento para la IA?
Los datos de entrenamiento son fundamentales porque determinan la capacidad del modelo de IA para aprender, generalizar y resolver problemas en la práctica. Sin datos adecuados, el modelo no puede desarrollar habilidades ni mejorar su precisión o confiabilidad.
¿Cómo funcionan los datos de entrenamiento en el proceso de aprendizaje de un modelo de IA?
Durante el entrenamiento, el modelo analiza los datos proporcionados, detecta patrones o regularidades y ajusta sus parámetros internos para reducir errores en sus predicciones o clasificaciones. El proceso se repite muchas veces hasta que el modelo alcanza un nivel aceptable de desempeño.
¿Qué tipos de datos pueden usarse para entrenar modelos de Inteligencia Artificial?
Dependiendo de la tarea, pueden utilizarse datos como imágenes para reconocimiento visual, texto para procesamiento de lenguaje natural, audio para reconocimiento de voz, datos numéricos para análisis predictivo y muchos otros formatos. Es esencial que los datos sean relevantes y de calidad para obtener buenos resultados.
¿Qué riesgos existen si los datos de entrenamiento no son adecuados?
Si los datos de entrenamiento contienen errores, sesgos, información insuficiente o poco representativa, el modelo puede aprender patrones incorrectos, tomar decisiones erróneas o replicar discriminaciones existentes, lo que puede afectar negativamente su utilidad y confiabilidad.
¿Cómo se asegura la calidad de los datos de entrenamiento?
La calidad se garantiza mediante la selección cuidadosa de la fuente de datos, la limpieza y depuración de errores, la eliminación de duplicados, el balanceo de clases y la revisión constante para detectar posibles sesgos o desajustes. Un proceso riguroso ayuda a mejorar el desempeño del modelo.
¿Cuál es la diferencia entre datos de entrenamiento, validación y prueba?
Los datos de entrenamiento se usan para enseñar al modelo, los de validación sirven para ajustar parámetros y evitar sobreajuste, y los de prueba evalúan el desempeño final del modelo en escenarios no vistos durante el entrenamiento. Separar estos conjuntos es esencial para medir de forma precisa la capacidad del modelo.
¿Qué limitaciones tienen los modelos de IA en relación a los datos de entrenamiento?
El modelo solo puede aprender lo que está presente en los datos de entrenamiento. Si ciertos casos o situaciones no están representados, el modelo puede fallar ante situaciones nuevas o inusuales. Además, la calidad y diversidad de los datos influyen directamente en las capacidades y limitaciones del modelo.
¿Cómo pueden los datos de entrenamiento impactar en la ética y responsabilidad del uso de la IA?
Los datos de entrenamiento pueden contener sesgos históricos o sociales que se transfieren al modelo, lo que puede generar resultados injustos o discriminatorios. Por eso, es fundamental revisar y curar los datos, promoviendo la transparencia y el uso responsable de la tecnología.
¿Qué beneficios aporta usar buenos datos de entrenamiento en proyectos de Inteligencia Artificial?
El uso de datos de entrenamiento de calidad permite desarrollar modelos más precisos, confiables y aplicables en situaciones reales. Esto mejora la toma de decisiones, la automatización de tareas y el aprovechamiento responsable de la IA en ámbitos como la educación, el trabajo y proyectos innovadores.
Posts Relacionados
Artículo producido y publicado de conformidad con nuestra Política Editorial:
https://xiluvo.com/politica-editorial/Publicado em: 05 de Fevereiro de 2026
Categorías de contenido del sitio:
Inteligencia Artificial
IA en 2030
Futuro de la IA
FAQS
Este contenido forma parte del ecosistema editorial de Xiluvo Inteligencia Artificial, que Incluye:
Página inicial
Glossário Intelegencia Artificial
Contato: https://xiluvo.com/contacto/

Aviso Editorial
Este contenido fue estructurado con el apoyo de Inteligencia Artificial y sometido a rigurosa curaduría, verificación de datos y revisión final por el Editor Jefe Timóteo Sinate. Xiluvo reafirma su compromiso con la ética editorial, garantizando que el juicio editorial y la validación de la información son de entera responsabilidad humana.
Autor: Timóteo Sinate – Fundador y Editor Jefe de Xiluvo Revisado por: Timóteo Sinate – Xiluvo Inteligencia Artificial Producido de conformidad con nuestra Política Editorial | Disclaimer | Política de Correcciones y Retractaciones | Contato | Política de Monetización y Transparencia Comercial | Sobre Nosotros | Política de Privacidad | Política de Cookies|